- El preentrenamiento continuo mejora la generalización de los agentes en entornos virtuales diversos mediante el equilibrio entre volumen de datos y diversidad.
- El enfoque Agentic CPT integra razonamiento multi-paso y uso de herramientas antes del ajuste fino, optimizando la capacidad de decisión.
- El post-entrenamiento combina métodos offline, simulaciones y feedback en tiempo real para refinar la precisión motora y la adaptación al mundo físico.
Cuando hablamos de agentes encarnados, nos metemos en un terreno fascinante donde la inteligencia artificial ya no se queda encerrada en una pantalla, sino que tiene que interactuar con el mundo físico o simulaciones hiperrealistas. Para que estos sistemas no se queden cortos, se está impulsando el llamado preentrenamiento continuo (CPT), una técnica que busca que el modelo no solo aprenda conceptos básicos, sino que desarrolle una capacidad de generalización real para moverse en entornos que nunca ha visto antes.
La movida aquí es que no basta con darle datos a saco; hay que saber cómo mezclarlos. El reto actual es lograr que un agente sea capaz de pasar de un mundo virtual, como Minecraft, a otro totalmente distinto sin que se quede colgado. Para conseguirlo, se están diseñando marcos metodológicos complejos que combinan el volumen de datos, la diversidad de los escenarios y el tamaño del modelo para encontrar el punto exacto donde la IA deja de repetir patrones y empieza a razonar sobre el entorno.
El impacto del volumen y la diversidad de datos
Se ha comprobado que meterle más horas de entrenamiento a un agente mejora notablemente su rendimiento en los mundos que ya conoce. Sin embargo, hay un matiz importante: la cantidad no lo es todo. Para que un agente sea capaz de transferir sus conocimientos a mundos relacionados, la diversidad de los datos es la verdadera clave. Si el entrenamiento es demasiado homogéneo, el agente se vuelve un experto en un solo sitio pero un completo inútil en cualquier otro entorno distante.
Curiosamente, se ha detectado una ley de escalado empírica que vincula la pérdida de validación con el tamaño del modelo y la variedad de los datos. Los modelos más grandes suelen ser más eficientes procesando la información, pero ojo, que si se entrenan en un solo mundo, pueden generalizar peor que los pequeños cuando se les lanza a escenarios desconocidos. Esto nos dice que necesitamos un equilibrio inteligente entre la potencia del modelo y la riqueza de las experiencias virtuales.
Agentic CPT: Elevando el razonamiento del agente
Una de las innovaciones más potentes es el Agentic CPT, un paradigma que no se limita a predecir el siguiente token, sino que integra comportamientos de agente directamente en el ciclo de preentrenamiento. Esto incluye la capacidad de planificar acciones en varios pasos, usar herramientas de forma autónoma y mejorar por cuenta propia. A diferencia del entrenamiento convencional, aquí se busca que el modelo ya tenga unos sesgos agenticos antes incluso de pasar por la etapa de ajuste fino o alineación.
Para alimentar este sistema, se utilizan dos métodos de síntesis de datos muy interesantes. Por un lado, la Síntesis de Acción de Primer Orden (FAS), que crea secuencias de razonamiento y acción basadas en corpus abiertos. Por otro, la Síntesis de Acción de Orden Superior (HAS), que es más compleja porque genera múltiples ramificaciones de decisión, permitiendo que la IA aprenda a sopesar diferentes opciones y elija la más óptima en situaciones dinámicas.
Post-entrenamiento y optimización de políticas
Una vez que el modelo tiene una base sólida, entra en juego el post-entrenamiento, donde se refinan las habilidades mediante diversas señales de aprendizaje. Podemos dividir esto en varias estrategias según de dónde venga la experiencia. El post-entrenamiento offline utiliza datos fijos, como demostraciones de expertos, para ajustar la política del agente sin necesidad de interactuar en tiempo real con el entorno, lo que ahorra costes y riesgos.
Si queremos subir el nivel, pasamos al aprendizaje interactivo en el mundo real. Aquí, el robot o agente ejecuta acciones, falla, recibe correcciones humanas y actualiza su política sobre la marcha. Esta interacción es vital para tareas de alta precisión, como la manipulación robótica compleja, donde el feedback táctil y la corrección inmediata son los que marcan la diferencia entre el éxito y el desastre.
Simulaciones y el puente hacia la realidad
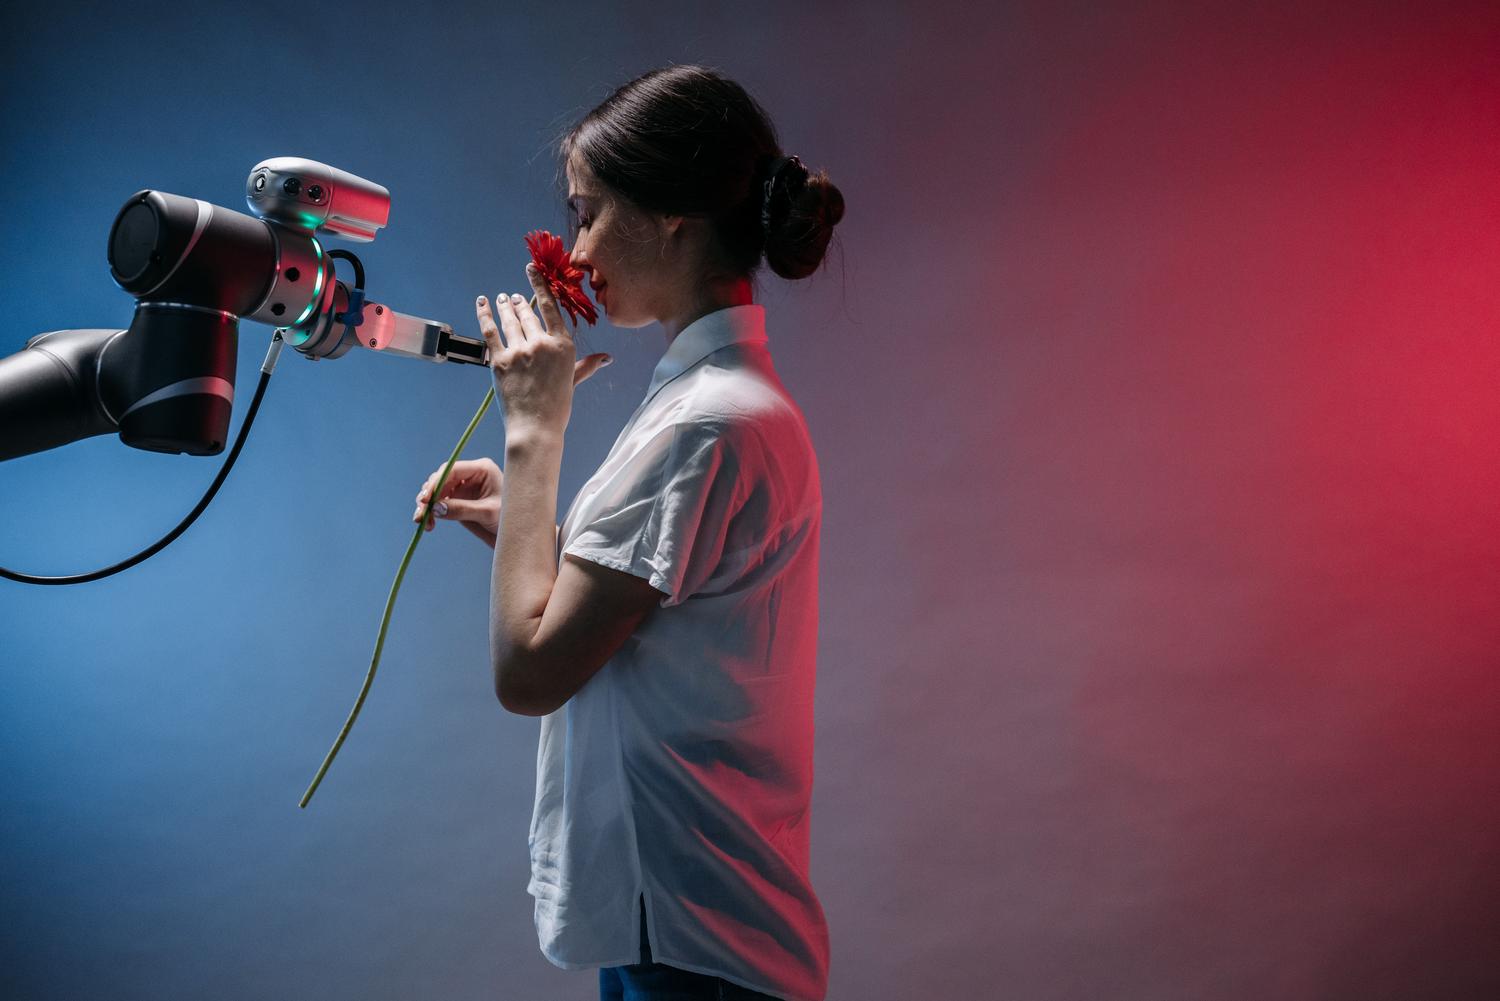
Entrenar en el mundo físico es lento y caro, por eso el post-entrenamiento basado en simulación es tan crucial. Mediante el uso de simuladores de física o modelos de mundo aprendidos, los agentes pueden generar millones de trayectorias imaginarias. Esto permite optimizar la política mediante el aprendizaje por refuerzo (RL) en un entorno seguro antes de saltar al hardware real, un proceso conocido como transferencia sim-to-real.
Existen enfoques avanzados como el entrenamiento coordinado, donde se mezclan datos reales y virtuales para evitar que el agente se acostumbre a las imperfecciones del simulador. Además, la implementación de arquitecturas Mixture-of-Experts (MoE) ha demostrado ser muy robusta en estas condiciones, ya que permite que diferentes partes del modelo se especialicen en distintos tipos de tareas o entornos, optimizando el uso de los recursos computacionales.
Desafíos técnicos y rutas futuras
A pesar de los avances, todavía hay piedras en el camino. Uno de los problemas más gordos es el olvido catastrófico: cuando el agente aprende una tarea nueva, a veces borra lo que ya sabía hacer. Para evitar esto, se están desarrollando mecanismos de repetición y estrategias de aprendizaje curricular, donde el agente se expone a secuencias de acción cada vez más complejas de forma gradual.
Otro punto crítico es la fiabilidad de las recompensas. En el aprendizaje por refuerzo, si la señal de éxito no está bien definida, el agente puede encontrar atajos fraudulentos (reward hacking) para ganar la recompensa sin cumplir realmente el objetivo. El futuro pasa por crear verificadores más robustos y sistemas de auto-reflexión donde la IA pueda analizar sus propios errores de movimiento y corregirlos autónomamente.
La evolución de los agentes encarnados depende de nuestra capacidad para fusionar un preentrenamiento masivo y diverso con etapas de refinamiento interactivo y simulado. Al separar la adquisición de capacidades generales de la alineación con tareas específicas, estamos logrando que los modelos de visión-lenguaje-acción sean mucho más adaptables y eficientes, sentando las bases para robots y agentes virtuales que puedan operar en el caos del mundo real con una autonomía sin precedentes.