- La transición de la atención cuadrática a la lineal permite procesar millones de tokens reduciendo drásticamente el coste computacional y la memoria del KV cache.
- Las arquitecturas híbridas combinan capas de atención exacta con módulos recurrentes o SSM para equilibrar la precisión en la recuperación de datos con la eficiencia.
- La extensión del contexto requiere optimizaciones avanzadas en codificación posicional, como YaRN o LongRoPE, y kernels optimizados como FlashAttention.
Cuando hablamos de modelos de lenguaje modernos, uno de los mayores quebraderos de cabeza es el llamado muro cuadrático de la atención. Básicamente, esto significa que si duplicas la longitud del texto que el modelo debe procesar, el esfuerzo computacional no se duplica, sino que se cuadruplica, lo que convierte la gestión de documentos larguísimos en una pesadilla de ingeniería y costes. Para solucionar este entuerto, la industria está moviéndose hacia la atención lineal, una familia de técnicas que buscan que el coste crezca de forma proporcional a la longitud de la secuencia, haciendo que leer millones de tokens sea económicamente viable.
La movida no es solo cuestión de potencia bruta, sino de cómo gestionamos la memoria, específicamente el KV cache, que es donde se guardan las claves y valores de los tokens previos. En contextos masivos, el almacenamiento de este cache puede llegar a ocupar terabytes, superando con creces el peso de los propios pesos del modelo. Por eso, el despliegue de arquitecturas subcuadráticas e híbridas se ha vuelto la norma, permitiendo que la IA razone sobre repositorios de código enteros o historiales de agentes infinitos sin que el servidor explote en el intento.
El salto de la atención cuadrática a la lineal
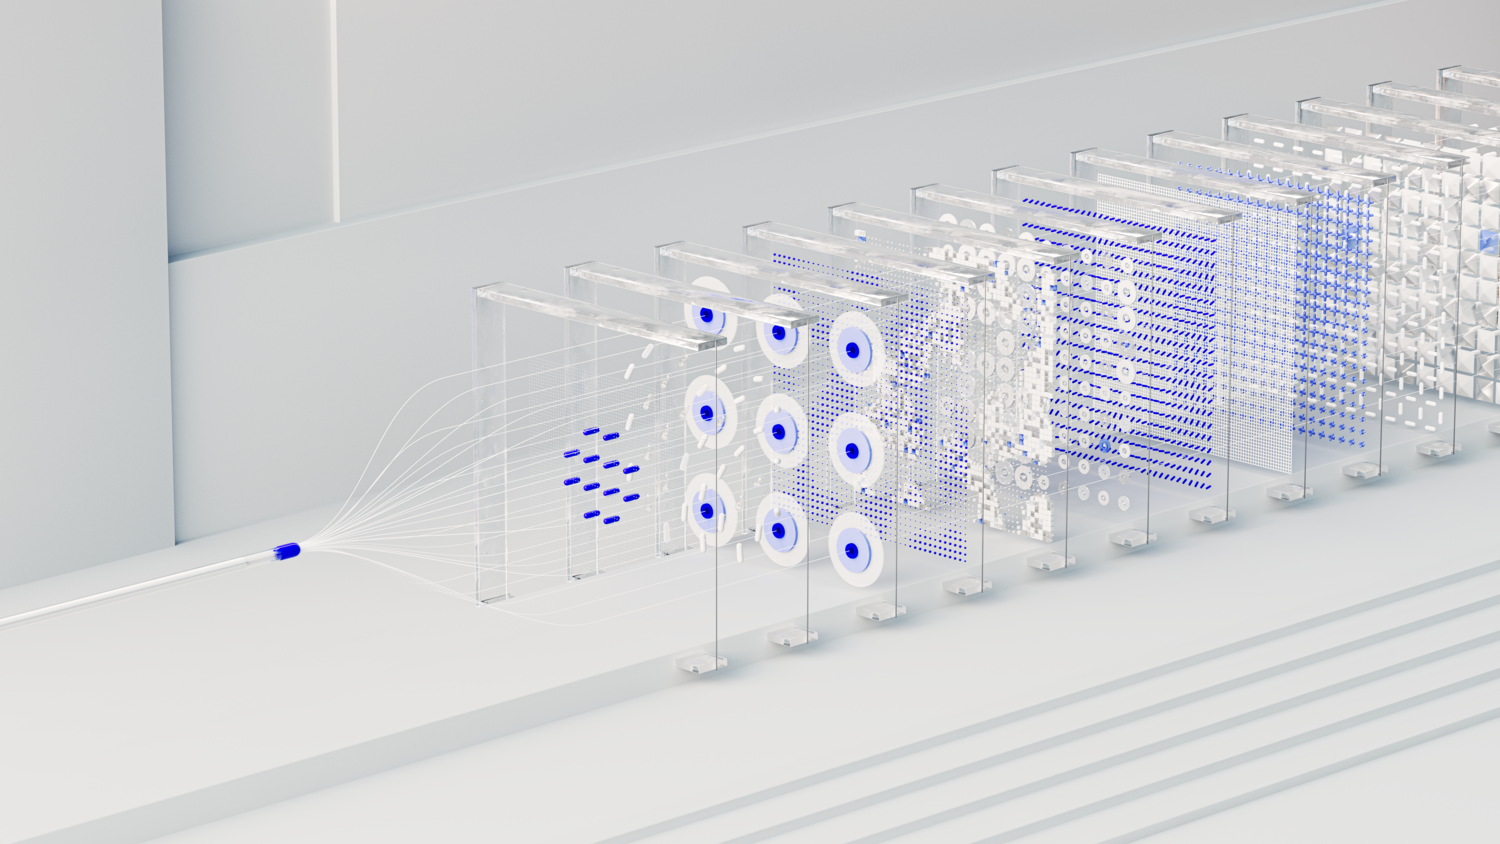
La atención estándar de los Transformers utiliza un mecanismo de softmax que requiere comparar cada token con todos los demás, lo que genera esa complejidad O(n²). La atención lineal rompe este esquema mediante aproximaciones de kernel o formulaciones recurrentes, transformando el proceso en algo similar a una RNN donde el pasado se comprime en un estado oculto de tamaño fijo. Esto significa que el tiempo de inferencia por token es constante, O(1), independientemente de cuánta información haya procesado el modelo anteriormente.
Existen diversas variantes para lograr esto. Por ejemplo, el uso de funciones de características aleatorias permite aproximar la atención softmax, mientras que otros modelos optan por dinámicas de pesos rápidos. Sin embargo, hay un problema: la compresión con pérdida. Al intentar meter todo el historial en un estado fijo, el modelo puede olvidar detalles precisos, lo que provoca que la capacidad de recuperación de información (el famoso recall) decaiga comparada con la atención exacta.
Arquitecturas Híbridas: Lo mejor de dos mundos
Para no tener que elegir entre eficiencia y precisión, han nacido los modelos híbridos. La estrategia consiste en intercalar unas pocas capas de atención completa (que se encargan de la recuperación exacta de datos) con muchas capas recurrentes o de estado espacial (SSM) que gestionan el flujo de información general. Modelos como Jamba o Qwen3-Next utilizan variantes de Gated DeltaNet o módulos Mamba para reducir el uso de compute y memoria entre 4 y 10 veces sin sacrificar apenas la calidad.
Esta combinación es el punto dulce de la ingeniería actual. Mientras que las capas de atención densa actúan como un ancla de precisión, las capas lineales permiten que el modelo mantenga una ventana de contexto masiva sin que el coste de inferencia se dispare. Es la diferencia entre poder servir a un solo usuario por cada GPU H100 o poder atender a decenas de ellos simultáneamente con la misma infraestructura.
La batalla de la codificación posicional
No basta con cambiar la matemática de la atención; también hay que decirle al modelo dónde está cada palabra. El estándar es RoPE (Rotary Position Embedding), pero cuando intentamos extender la ventana de entrenamiento, el modelo se encuentra con posiciones que nunca vio, y ahí es donde empieza a alucinar. Para remedy esto, se utilizan técnicas como YaRN o la interpolación de posiciones, que ajustan las frecuencias de rotación para que el modelo pueda generalizar a longitudes mucho mayores.
Otra alternativa es el NoPE (sin codificación posicional), que sorprendentemente funciona bien en algunas tareas de largo contexto, aunque suele fallar en la gestión de información local. Por eso, la tendencia es usar esquemas híbridos de posicionamiento: RoPE para capturar detalles finos y locales, y NoPE o escalas ajustadas para la agregación global de información a través de millones de tokens.
Optimización del Hardware y Kernels
En la práctica, el software debe hablar el lenguaje del hardware. Aquí es donde entra FlashAttention. En lugar de calcular la matriz de atención completa en la memoria principal (HBM), que es lentísima, FlashAttention hace que los cálculos ocurran en la SRAM del chip, moviendo los datos en bloques. Esto no cambia la complejidad matemática, pero elimina el cuello de botella de entrada y salida de datos, haciendo que el proceso sea varias veces más rápido.
Con la llegada de las GPUs Hopper y Blackwell, hemos visto la evolución hacia FA3, que aprovecha el hardware asíncrono para solapar la carga de memoria con el cálculo. Además, para manejar contextos de millones de tokens, se emplea la atención en anillo (Ring Attention), que distribuye la secuencia a través de múltiples GPUs, pasando los fragmentos del KV cache en un círculo para que cada dispositivo procese una parte sin saturar la memoria de ninguno.
El problema del contexto efectivo frente al anunciado
Hay que tener cuidado con el marketing: que un modelo diga que soporta 1 millón de tokens no significa que los use todos con eficacia. Existe un fenómeno llamado dilución del contexto, donde la información relevante se pierde entre una montaña de ruido. El famoso efecto «Lost in the Middle» demuestra que los modelos recuerdan muy bien el principio y el final del texto, pero se vuelven torpes con lo que hay en el medio.
Para combatir esto, se han desarrollado benchmarks más exigentes como RULER, que van más allá de la simple tarea de encontrar una aguja en un pajar. La realidad es que el contexto efectivo suele ser una fracción del anunciado. Por ello, para muchas aplicaciones, sigue siendo más barato y preciso usar RAG (Generación Aumentada por Recuperación) para filtrar la información antes de pasarla al modelo, en lugar de confiar ciegamente en que la ventana de contexto lo resuelva todo.
Manejo del KV Cache y Cuantización
El verdadero asesino de la memoria en contextos largos es el KV cache. Para un modelo de 70B, un millón de tokens en precisión completa puede requerir cientos de gigabytes de VRAM. La solución pasa por la cuantización agresiva, bajando la precisión del cache a FP8 o incluso INT4. Esto reduce el espacio necesario a la mitad o a la cuarta parte con una pérdida de calidad mínima, permitiendo que más usuarios compartan la misma GPU.
También se están implementando estrategias de evicción, donde el modelo descarta partes del cache que considera irrelevantes, o el uso de sumideros de atención (attention sinks), que consisten en mantener siempre los primeros tokens de la secuencia para estabilizar la distribución de la atención. Estas optimizaciones son las que permiten que la inferencia de contexto largo pase de ser un experimento de laboratorio a un producto viable en producción.
La evolución hacia la atención lineal y los sistemas híbridos está transformando la IA, permitiendo que el procesamiento de volúmenes masivos de datos sea fluido y asequible. Al combinar kernels optimizados, cuantización de memoria y nuevas formas de entender la posición de los tokens, hemos pasado de luchar contra el muro cuadrático a gestionar ventanas de información casi infinitas, aunque la clave del éxito siga siendo equilibrar la capacidad de recuerdo exacto con la eficiencia computacional.